Un segundo cerebro no se mide en cuántos tokens lee, se mide en lo que sigue en pie seis meses después
Esta semana un creador de contenido ha enseñado un segundo cerebro con Claude Code y NotebookLM que lee siete millones de tokens.
Siete millones.
Es una cifra que impresiona, y está hecha para eso. Cabe en una miniatura, cabe en un titular y deja una sensación muy clara: si lee tanto, ya está, problema resuelto.
Yo tengo otra cifra para ti. La noche del 9 de octubre, un agente de mi sistema leyó un millón doscientas cincuenta y cinco mil palabras en veintiocho minutos. Toda la obra de un autor, en varios idiomas, con dieciséis lectores trabajando a la vez.
Una demo preciosa.
Y a las cuatro de la mañana, cuando les tocaba trabajar al resto de agentes, ninguno pudo arrancar.
Leer mucho es la parte fácil
Que un modelo lea mucho ya no es noticia. Las ventanas de contexto crecen cada pocos meses, y montar algo que trocee una biblioteca y la pase por un modelo está al alcance de cualquiera con una tarde libre y un tutorial.
No lo critico. Está bien que se pueda.
El problema es lo que esa cifra no dice. No dice qué pasa la segunda noche. Ni la décima. No dice qué ocurre cuando el proceso se cuelga a mitad, cuando el proveedor te corta, cuando una nota cambia de sitio o cuando dos tareas quieren lo mismo a la vez. No dice quién se entera.
Un segundo cerebro no es una lectura. Es algo que tiene que seguir funcionando cuando no lo miras, meses, con tus notas cambiando por debajo.
Es como juzgar un edificio por lo rápido que se levantó la grúa. La grúa es espectacular. Lo que importa es lo que queda en pie cuando la grúa se va.
La noche que leer mucho tumbó el sistema
Os cuento el caso con detalle, porque es el mejor argumento que tengo y no me deja precisamente bien.
En mi vault tengo un agente que se llama «destilador». Coge la obra de un autor, la lee entera y la convierte en un «mini cerebro»: un puñado de notas atómicas con sus reglas de decisión, sus modelos mentales y sus ideas, cada una comprobada contra el texto original para que no se invente nada.
El 8 de octubre le dejé encargados varios autores para esa noche. El primero, a medianoche, un conocido autor estadounidense de desarrollo personal. Material enorme: transcripciones de cursos, libros en inglés y en español, tres PDF escaneados que hubo que pasar por OCR. Más de un millón doscientas mil palabras.
El destilador hizo exactamente lo que se le había enseñado a hacer con material grande. Repartió la lectura entre 16 lectores en paralelo, fundió sus inventarios en un plan de 209 notas y puso a 7 escritores a volcarlas a la vez.
A las 00:29 la tarjeta estaba cerrada. 209 notas, cero fallos en la comprobación contra el texto original, el índice actualizado. Veintiocho minutos.
Si yo grabase vídeos de demos, ese sería el vídeo.
Lo que no sale en el vídeo es lo de después. Esos 23 procesos en paralelo se habían comido la cuota de la suscripción. La ventana de cinco horas, gastada en media hora. Y a las 4:00 de la mañana el tablero empezó a despachar lo que tocaba: Séneca, Musonio Rufo, el informe semanal del vault, las analíticas de YouTube…
Todos murieron al arrancar.
El registro de esa madrugada lo cuenta mejor que yo. Tarjeta reclamada a las 4:01. A las 4:03, devuelta: el log del agente había dejado de escribirse a los cero minutos. Segundo intento por el arnés de respaldo a las 4:04. Muerta otra vez a las 4:06. Bloqueada: intentos agotados. Y así una tras otra.
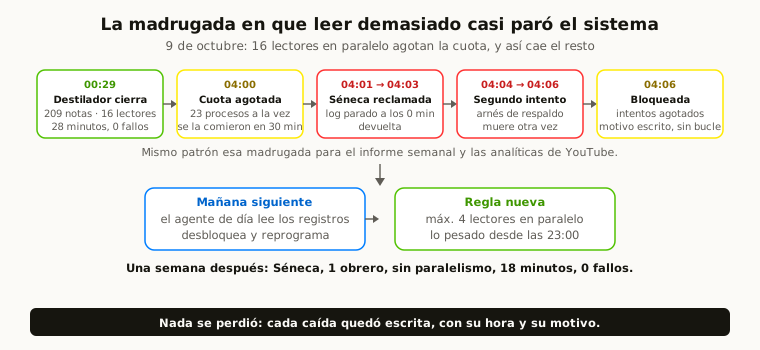
El sistema hizo su mejor lectura de la historia y, por hacerla, dejó sin trabajar a todo lo demás.
¿Se perdió algo? No. Y esa es la parte que me interesa.
Lo que de verdad se mide: el Registro
Nada de eso desapareció en silencio. Cada tarjeta dejó escrito en su propio Registro qué le había pasado y a qué hora. Cada caída al arnés de respaldo mandó un aviso al móvil. Las que agotaron intentos quedaron bloqueadas con su motivo, no reintentándose en bucle quemando lo poco que quedaba.
A la mañana siguiente, el agente que me atiende de día leyó esos registros, entendió que era la cuota, desbloqueó las tarjetas y las reprogramó para cuando se reiniciara el límite. Y de ahí salieron dos reglas que hoy viven escritas en el propio encargo:
- Como máximo 4 lectores en paralelo. Si el material es enorme, se priorizan los lotes principales y el resto se deja anotado.
- El trabajo pesado arranca a las 23:00, un poco cada noche. No todo de golpe.
Una semana después, el 16 de octubre a las 23:00, Séneca. Cuatro tratados, unas 72.600 palabras. Un solo obrero, sin lectores en paralelo. 63 notas, cero fallos, dieciocho minutos.
Menos espectacular. Y a las cuatro de la mañana el resto del tablero trabajó con normalidad.
Eso es un segundo cerebro madurando. No lee más que antes. Lee de una forma que deja vivo todo lo demás.
Cada lunes a las cuatro de la mañana otro agente me deja un informe de la semana anterior. El de la semana del 5 al 12 de octubre, la de aquella noche, dice esto:
- 107 tarjetas cerradas por 27 perfiles distintos, de media 7 minutos de reclamar a cerrar.
- 143 despachos del lanzador.
- 33 zombis rescatados: procesos que se quedaron colgados y cuyo trabajo volvió a la cola.
- 11 caídas al arnés de respaldo.
- 0 tarjetas bloqueadas al cerrar la semana.
Fijaos en que esos números no presumen de nada. Treinta y tres zombis en una semana es mucho. Pero están contados, y cada uno tiene su línea con hora y motivo. Ese informe no lo escribo para que quede bonito. Lo escribo para enterarme de lo que se rompió mientras dormía.
Ese es el dato que me dice si mi segundo cerebro funciona. No cuánto lee.
«Si lee 7 millones de tokens, ¿qué más hace falta?»
Es la objeción obvia y la entiendo. Si el modelo puede tener todo tu conocimiento delante de una vez, ¿para qué tanto tablero, tanto registro y tanta regla?
Porque leer no es lo mismo que seguir funcionando.
Una lectura es un evento. Tú pulsas, el modelo lee, te contesta, se acaba. Un segundo cerebro es un proceso que dura años, y en ese tiempo pasan cosas que ninguna ventana de contexto arregla:
- Tus notas se mueven, se renombran, se archivan. Lo que leyó ayer hoy está en otra carpeta.
- El proveedor te corta, te cambia el precio o caduca una credencial a las tres de la mañana.
- Dos procesos compiten por lo mismo. O uno se cuelga a mitad y deja el trabajo a medias.
- Y la peor: algo falla y nadie se entera, porque todo parece ir bien.
Mi caso del 9 de octubre es justo eso. La capacidad de lectura no faltó. Sobró. Lo que salvó la noche no fue leer más, fue tener un sistema que frena, avisa y deja escrito.
Y lo digo con todas las cartas sobre la mesa: mi tablero lleva dos meses funcionando, no seis. No te vendo que haya llegado. Te digo dónde está la vara. Seis meses en producción, sin que yo mire cada noche, es lo que convierte un montaje en un sistema. Y eso solo se demuestra con el registro de esos seis meses, no con una cifra de un día.
Demo contra sistema en producción
| Demo de segundo cerebro | Segundo cerebro en producción | |
|---|---|---|
| Qué enseña | Cuánto lee de una vez | Qué pasa cuando algo se rompe |
| Cuándo se evalúa | El día que se graba | Cada semana, durante meses |
| Cifra estrella | Tokens leídos | Zombis, reintentos, bloqueos, tiempo de cierre |
| Si se cuelga | Se repite la toma | El trabajo vuelve a la cola, con su motivo escrito |
| Si se acaba la cuota | No pasa, la demo dura minutos | Pasa, y tiene que estar previsto |
| Quién se entera de un fallo | Nadie, porque no hay fallo | Tú, por el aviso y por el informe del lunes |
| Lo que deja | Una buena impresión | Una regla nueva cada vez que algo falla |
La columna de la izquierda no está mal. Es el primer paso de todos, también el mío. El problema es quedarse ahí y creer que ya tienes la de la derecha.
Cómo empezar a medir el tuyo
No hace falta montar mi tablero para aplicar esto. Hace falta cambiar la pregunta: de «¿cuánto lee?» a «¿qué pasa cuando falla, y cómo me entero?».
Os dejo los pasos que yo seguiría si empezase hoy, en este orden:
-
Que cada tarea deje escrito qué hizo. Una línea con fecha, hora, qué se trabajó y cómo acabó. En una nota, no en la memoria del chat. Si no hay registro, no hay sistema: hay suerte.
-
Que deje escrito también cuándo empieza, no solo cuándo termina. Una tarea que lleva una hora «en curso» sin decir nada es indistinguible de una colgada. Y la tentación de matarla a mano destruye trabajo bueno.
-
Ponle un tope a los reintentos. Algo que falla dos veces seguidas por lo mismo no va a funcionar a la tercera. Bloquéalo con su motivo y que espere a que lo mires. Reintentar sin límite es la forma más rápida de gastar la cuota en nada.
-
Mide el consumo antes de que te lo mida el proveedor. Si una tarea puede lanzar procesos en paralelo, ponle un máximo. Yo lo aprendí con dieciséis lectores; tú puedes aprenderlo leyendo esto.
-
Haz que los fallos hagan ruido. Un aviso al móvil cuando algo cae al plan B. Un respaldo que funciona demasiado bien oculta la avería: todo sigue cerrando y nadie se da cuenta de que lo principal lleva días muerto.
-
Una vez por semana, un informe que cuente lo que se rompió. No lo que se hizo. Lo que se rompió, se reintentó y se corrigió. Ese papel, semana tras semana, es la prueba de que tu segundo cerebro aguanta.
-
Cada fallo deja una regla. En mi sistema la norma es que toda cicatriz acaba en una comprobación automática o, como mínimo, en una regla escrita donde el agente la lea. Si el fallo no cambia nada, volverá.
Pasito a pasito. Ninguno de estos puntos necesita leer siete millones de nada.
Errores típicos
Elegir herramienta por la cifra de contexto. Es elegir coche por la velocidad punta para ir a por el pan. Lo que vas a usar cada día es otra cosa: que arranque, que no se pare a mitad, que te avise si algo va mal.
Paralelizar porque se puede. Más lectores a la vez parece gratis hasta que no lo es. Mi noche del 9 de octubre es exactamente esto. El paralelismo es un recurso que compite con todo lo demás que tiene que correr esa noche.
Confundir «no me ha fallado» con «no ha fallado». Si tu sistema no deja registro, no sabes si ha fallado. Solo sabes que no te has enterado. Los treinta y tres zombis de mi semana estaban ahí igual; la diferencia es que yo los tengo contados.
Evaluarlo el primer día. El primer día todo funciona. Es el día que lo has montado, con todo fresco y mirándolo. La evaluación honesta empieza cuando dejas de mirar.
Copiar la demo entera de golpe. Monta lo mínimo, déjalo correr una semana, lee lo que se ha roto y añade la siguiente pieza. Un sistema que crece así aguanta. Uno que se monta entero en una tarde, normalmente no pasa del primer mes.
Lo que queda en pie
El 9 de octubre mi sistema hizo la lectura más grande de su vida y, por hacerla, dejó tirado a todo lo demás.
Y al día siguiente no tuve que reconstruir nada. Estaba todo escrito: qué había pasado, a qué hora, en qué tarjeta. Se corrigió en una mañana y quedó una regla para que no vuelva a pasar.
Eso no cabe en una miniatura. Pero es lo que hace que dentro de seis meses siga funcionando, y dentro de dos años también. Cada fallo que deja una regla hace el sistema un poco más sólido que la semana anterior. Efecto compuesto, aplicado a lo que se rompe.
La próxima vez que veas un segundo cerebro que lee millones de tokens, haz una sola pregunta:
¿Y qué pasó la segunda noche?